
ข่าวนี้ออกมาตั้งแต่วันที่ 3 พฤศจิกายน แต่อ่านแล้วยังคิดต่ออยู่หลายวัน Maciej Szpunar ซึ่งเป็น Advocate General (ตำแหน่งที่ปรึกษาทางกฎหมายของศาล) ของศาลยุติธรรมแห่งสหภาพยุโรป (CJEU) ส่งความเห็นในคดี C-250/25 ระหว่าง Like Company ผู้ทำเว็บข่าวในฮังการี กับ Google Ireland ถือเป็นคดีแรกเรื่อง Generative AI กับลิขสิทธิ์ที่ขึ้นไปถึงศาลสูงสุดของ EU
ต้นเรื่องฟังดูไม่ค่อยจริงจังเท่าไหร่ มีผู้ใช้ขอให้ Gemini (ตอนนั้นยังชื่อ Bard) สรุปข่าวจากเว็บ balatonkornyeke.hu เรื่องนักร้องชาวฮังการีที่ฝันจะพาโลมามาอยู่ที่ทะเลสาบ Balaton แล้ว Gemini ก็ตอบมาเป็นบทสรุปยาว ๆ ฝั่งเว็บข่าวเลยฟ้องว่า Google เอาบทความไปใช้ทั้งตอนเทรนโมเดลและตอนตอบคำถาม โดยไม่ได้ขออนุญาตและไม่ได้จ่ายเงิน ที่ขำคือตัว Advocate General เองยังบรรยายว่าบทสรุปนั้นเป็นแบบ “ประมาณ ๆ” เสียมากกว่า
เรื่องการเทรนโมเดล Szpunar มองว่าคำถามส่วนนี้ไม่เกี่ยวกับคดีจริง เพราะไม่มีหลักฐานว่าบทความของ Like Company ถูกใช้เทรน Gemini แต่ก็ให้ความเห็นทิ้งไว้ว่า โดยหลักแล้วการเอางานที่มีลิขสิทธิ์ไปเทรนโมเดลภาษา (LLM) ทำได้ภายใต้ข้อยกเว้นเรื่องการทำเหมืองข้อความและข้อมูล (Text and Data Mining) ของ EU ซึ่งตามกฎหมายเจ้าของงานยังเลือกสงวนสิทธิ์ (opt-out) แบบที่เครื่องอ่านได้
ส่วนที่น่าสนใจจริง ๆ คือตอนที่ chatbot ไปดึงข่าวมาแบบเรียลไทม์ (เรียกว่า RAG หรือ grounding) แล้วเอามาเรียบเรียงเป็นคำตอบ ตรงนี้ Szpunar บอกว่าอาจละเมิดสิทธิ์ของผู้พิมพ์ข่าว (Press Publishers’ Right) ได้ในบางกรณี โดยดูสองเรื่อง หนึ่ง เข้าถึงบทความมาโดยมิชอบหรือเปล่า เช่น ทะลุ paywall หรือข้ามมาตรการกันการ scrape สอง คำตอบแค่เล่าข้อเท็จจริง หรือหยิบสำนวนการเขียนของต้นฉบับมาใช้จนจำได้ และมากพอที่คนอ่านไม่ต้องคลิกไปอ่านต้นฉบับอีกเลย ข้อเท็จจริงในข่าวไม่มีใครเป็นเจ้าของ แต่วิธีเขียนมีเจ้าของ และถ้าการใช้แบบนี้ฝังอยู่ในโมเดลธุรกิจ หรือผู้ให้บริการไม่มีมาตรการป้องกันที่ได้ผล คนที่ต้องรับผิดชอบก็คือผู้ให้บริการ chatbot
ต้องออกตัวก่อนว่านี่เป็นแค่ความเห็น ยังไม่ใช่คำพิพากษา ศาลไม่จำเป็นต้องทำตาม แม้ส่วนใหญ่มักจะเดินตาม คำตัดสินจริงจะตามมาภายหลัง และเป็นเรื่องของกฎหมาย EU ไม่ได้มีผลกับไทยโดยตรง
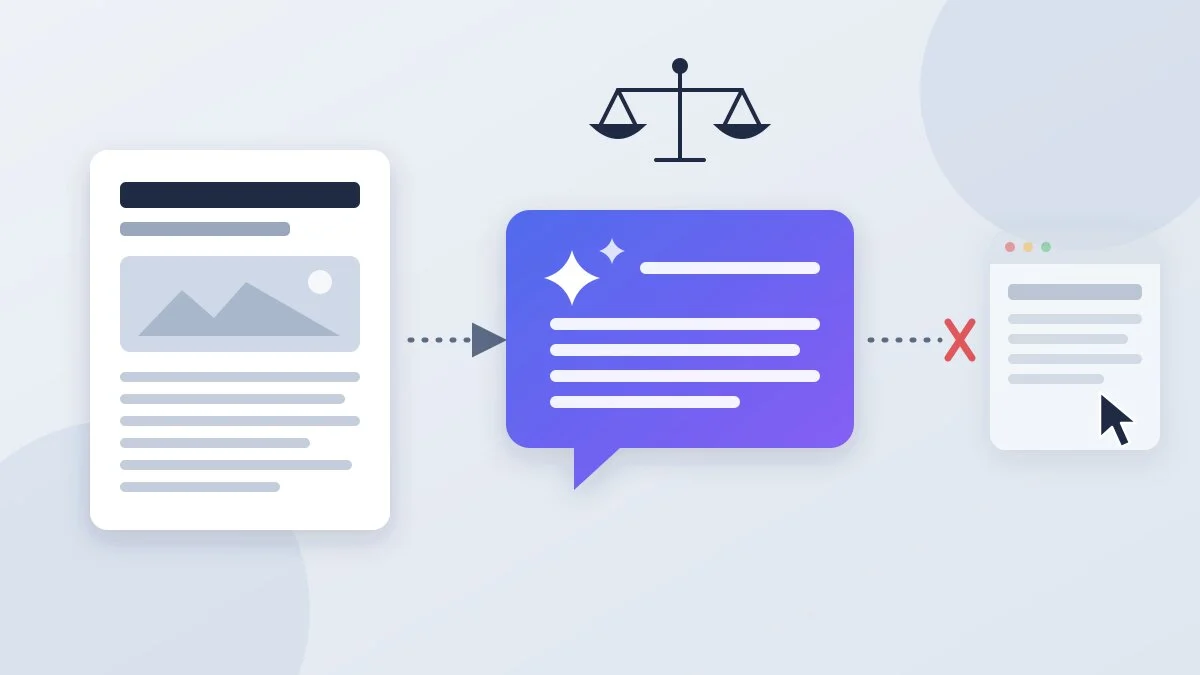
เคยเขียนเรื่อง Personal blogs ในยุค AI ไว้ไม่นานนี้ อ่านความเห็นนี้แล้วคิดว่าเกณฑ์ “อ่านคำตอบแล้วไม่ต้องไปอ่านต้นฉบับ” คือหัวใจของเรื่องเลย คนผลิตคอนเทนต์ส่วนใหญ่อยู่ได้ด้วยทราฟิคที่ Google ส่งมา และส่วนแบ่งค่าโฆษณาจาก Google ถ้า Google สรุปคำตอบให้จบในหน้าเดียวโดยไม่ส่งคนอ่านมาที่ต้นฉบับ รายได้ทั้งสองทางก็โดนกระทบโดยตรง ส่วนบล็อกส่วนตัวแบบนี้จะนับเป็น “สื่อสิ่งพิมพ์” ตามกฎหมายนี้ด้วยไหม ก็ไม่แน่ใจเหมือนกัน ตัวสิทธิ์นี้เขียนมาเพื่อสำนักข่าว แม้ Szpunar จะบอกว่านิยามค่อนข้างกว้างก็ตาม
ที่คนทำเว็บทำได้ตอนนี้คือบอก Google ผ่าน robots.txt ด้วย token ชื่อ Google-Extended แบบนี้
User-agent: Google-Extended
Disallow: /ตามเอกสารของ Google token นี้คุมทั้งการเอาเนื้อหาไปเทรน Gemini รุ่นต่อ ๆ ไป และการเอาไป grounding คำตอบใน Gemini Apps โดยไม่มีผลกับอันดับใน Google Search แต่แลกกับการที่เว็บจะไม่ถูกหยิบไปอ้างอิงในคำตอบของ Gemini และคำตอบ AI ในหน้า Google Search เองก็ยังผูกอยู่กับ Googlebot ไม่ได้อยู่ใต้ token นี้ นอกจากนี้ Google บอกว่าจะรองรับสัญญาณกลาง __usage_ai-training สำหรับบอกทุกค่ายพร้อมกันตั้งแต่ต้นปี 2027
ส่วน amphur.in.th ไม่ได้ block โดยส่วนตัวคิดว่ามัน block ไม่ได้จริงอยู่แล้ว อย่างที่เห็นว่าคำตอบ AI ใน Google Search เองก็ไม่ได้อยู่ใต้ token นี้ และคิดว่าในอนาคตน่าจะมีทางออกที่ Google หาวิธีที่เหมาะสมให้คนผลิตคอนเทนต์ได้ผลตอบแทน อาจจะมองโลกในแง่ดีเกินไปหน่อย แต่คนผลิตคอนเทนต์กับ Google ก็เหมือนอยู่ใน ecosystem เดียวกัน ต่างฝ่ายต่างต้องพึ่งพากัน ถ้าไม่มีคนเขียน AI ก็ไม่มีอะไรให้สรุป
ใครที่ทำบล็อกหรือเว็บอยู่ ตอนนี้ตั้งค่า robots.txt เรื่อง AI ไว้แบบไหนกันบ้างครับ?
ที่มา: Court of Justice of the EU – Press release No 155/26, TNW